16 de mayo de 2026: actualizado con las métricas más recientes sobre alucinaciones de IA y nuevos datos.
Resumen ejecutivo
Las alucinaciones de IA (casos en los que los modelos generan con total seguridad información falsa, inventada o sin respaldo) siguen siendo uno de los riesgos más importantes del trabajo con IA. La novedad clave de 2026 es que no existe una única «tasa de alucinación de la IA» universal. Cada benchmark mide un modo de fallo distinto: si un modelo se mantiene fiel a un documento, si adivina en lugar de admitir su incertidumbre, si cita correctamente las fuentes o si sus afirmaciones están realmente respaldadas a lo largo de una conversación de varios turnos.
Esa distinción importa. En tareas de resumen controladas, los mejores modelos pueden parecer muy fiables. En benchmarks más exigentes de tipo empresarial, preguntas jurídicas, tareas médicas, recuperación de citas o flujos de investigación de varios turnos, las tasas de error se disparan. Por eso la mitigación de alucinaciones mediante verificación multimodelo, la recuperación de información, la comprobación de fuentes y la revisión humana se están convirtiendo en requisitos estructurales, no en salvaguardas opcionales.
NOTA: la investigación completa sobre alucinaciones de IA, con tasas y benchmarks de 2026, está disponible en esta página.
Las cifras actualizadas más importantes:
- El 88 % de las organizaciones afirma usar ya la IA de forma habitual, pero casi dos tercios aún no han empezado a escalarla a toda la empresa, según la encuesta global sobre IA de 2025 de McKinsey.
- El 51 % de las organizaciones que usan IA ha sufrido al menos una consecuencia negativa, y casi un tercio de todos los encuestados declaró consecuencias derivadas de la inexactitud de la IA.
- El nuevo benchmark de alucinaciones de Vectara, más exigente, registra una tasa mínima del 3,3 %, mientras que varios modelos de razonamiento de vanguardia superan el 10 % en ese mismo benchmark.
- Columbia Journalism Review comprobó que ocho herramientas de búsqueda generativa dieron respuestas incorrectas en más del 60 % de las consultas de citas de noticias evaluadas.
- Stanford HAI constató que las herramientas de IA jurídica diseñadas específicamente para ello seguían alucinando entre más del 17 % y más del 34 % de las veces en consultas exigentes de investigación jurídica.
- La base de datos AI Hallucination Cases de Damien Charlotin ya registra 1.450 casos judiciales identificados relacionados con alucinaciones de IA o con resoluciones judiciales al respecto.
- ECRI situó el mal uso de los chatbots de IA en la sanidad como el peligro número uno de la tecnología sanitaria para 2026.
¿Qué es una alucinación de IA? (Definición técnica + en lenguaje sencillo)
En lenguaje sencillo
Una alucinación de IA se produce cuando un sistema de IA se inventa algo con total seguridad. Puede inventar una estadística, citar un estudio que no existe, citar mal una fuente real, fabricar un caso judicial o añadir datos que no figuraban en el documento que debía resumir. La respuesta suele sonar pulida y autorizada, y eso es precisamente lo que hace peligrosas las alucinaciones.
Definición técnica
En términos técnicos, la alucinación es un resultado generado que no está fundamentado en la entrada proporcionada, en la evidencia recuperada ni en la realidad de los hechos. En un artículo de 2026 conviene distinguir varios tipos de fallo en lugar de tratar todas las alucinaciones como una sola cosa:
- Alucinación de fidelidad: al resumir un documento que se le ha proporcionado explícitamente, el modelo lo contradice o añade información sin respaldo.
- Alucinación de factualidad: el modelo inventa hechos, acontecimientos, personas, estadísticas, artículos científicos o afirmaciones sin base en la realidad.
- Alucinación de citas: el modelo inventa una fuente, da una URL rota, cita el artículo equivocado o atribuye una afirmación real a la publicación equivocada.
- Fundamentación errónea: el modelo cita una fuente real, pero esa fuente no respalda la afirmación que hace.
- Fallo de abstención: el modelo debería decir «no lo sé», pero en su lugar adivina con total seguridad.
Por qué sucede
Los grandes modelos de lenguaje son sistemas de predicción. Generan texto verosímil a partir de patrones aprendidos de los datos de entrenamiento y del contexto, no porque «conozcan» directamente la verdad, como una base de datos que almacena registros verificados. La recuperación de información, la búsqueda web, las citas y el uso de herramientas pueden reducir el riesgo de alucinación, pero no lo eliminan: los modelos pueden seguir recuperando la fuente equivocada, malinterpretarla, generalizar en exceso a partir de ella o citarla en apoyo de una afirmación que no sostiene.
Cómo interpretar las estadísticas de alucinaciones de IA
El error más habitual en los artículos sobre alucinaciones es comparar cifras de benchmarks como si midieran lo mismo. No es así. Una tasa de alucinación del 3 % en resúmenes, una tasa de error del 60 % en citas y una tasa de fallos de fundamentación del 30 % en conversaciones de varios turnos pueden ser ciertas a la vez, porque proceden de tareas distintas.
| Benchmark o fuente | Qué mide | Cómo interpretar la cifra |
| Clasificación HHEM de Vectara | Si un modelo añade información sin respaldo al resumir los documentos proporcionados | Ideal para evaluar el resumen fundamentado y la fidelidad tipo RAG, no el conocimiento general del mundo |
| AA-Omniscience | Si un modelo adivina en lugar de abstenerse ante preguntas de conocimiento difíciles | Ideal para evaluar la gestión de la incertidumbre y el exceso de confianza, no la alucinación habitual por respuesta |
| Estudio de citas de Columbia Journalism Review | Si las herramientas de búsqueda con IA identifican correctamente el titular, el medio, la fecha y la URL de un artículo | Ideal para evaluar la fiabilidad de las citas y la recuperación, no todas las tareas de IA |
| OpenAI SimpleQA / PersonQA | Precisión factual y alucinación en respuestas breves a preguntas sobre hechos | Ideal para evaluar el recuerdo de hechos, sobre todo al comparar el comportamiento de los modelos de OpenAI |
| Estudio de Stanford HAI sobre IA jurídica | Alucinación y fundamentación errónea en herramientas de investigación jurídica | Ideal para evaluar el riesgo en la investigación jurídica |
| HalluHard | Respuestas de varios turnos que exigen citas en los ámbitos jurídico, de investigación, médico y de programación | Ideal para evaluar fallos de fundamentación difíciles y realistas en flujos de trabajo más largos |
Benchmark 1: clasificación de alucinaciones de Vectara (HHEM)
Qué mide
La clasificación de alucinaciones de Vectara mide la alucinación en tareas fundamentadas: con qué frecuencia un modelo introduce información sin respaldo al resumir un documento que se le ha proporcionado explícitamente. Piénsalo así: «¿Puede el modelo ceñirse a lo que tiene escrito delante?». Por eso Vectara es especialmente relevante para sistemas RAG, búsqueda empresarial, preguntas y respuestas sobre documentos y bots de soporte que deben responder a partir del conocimiento proporcionado.
Benchmarks de alucinaciones de IA (tabla en vivo), con la clasificación Vectara Hughes Hallucination Evaluation Model (HHEM) incluida.
Tasas de alucinación: conjunto de datos original
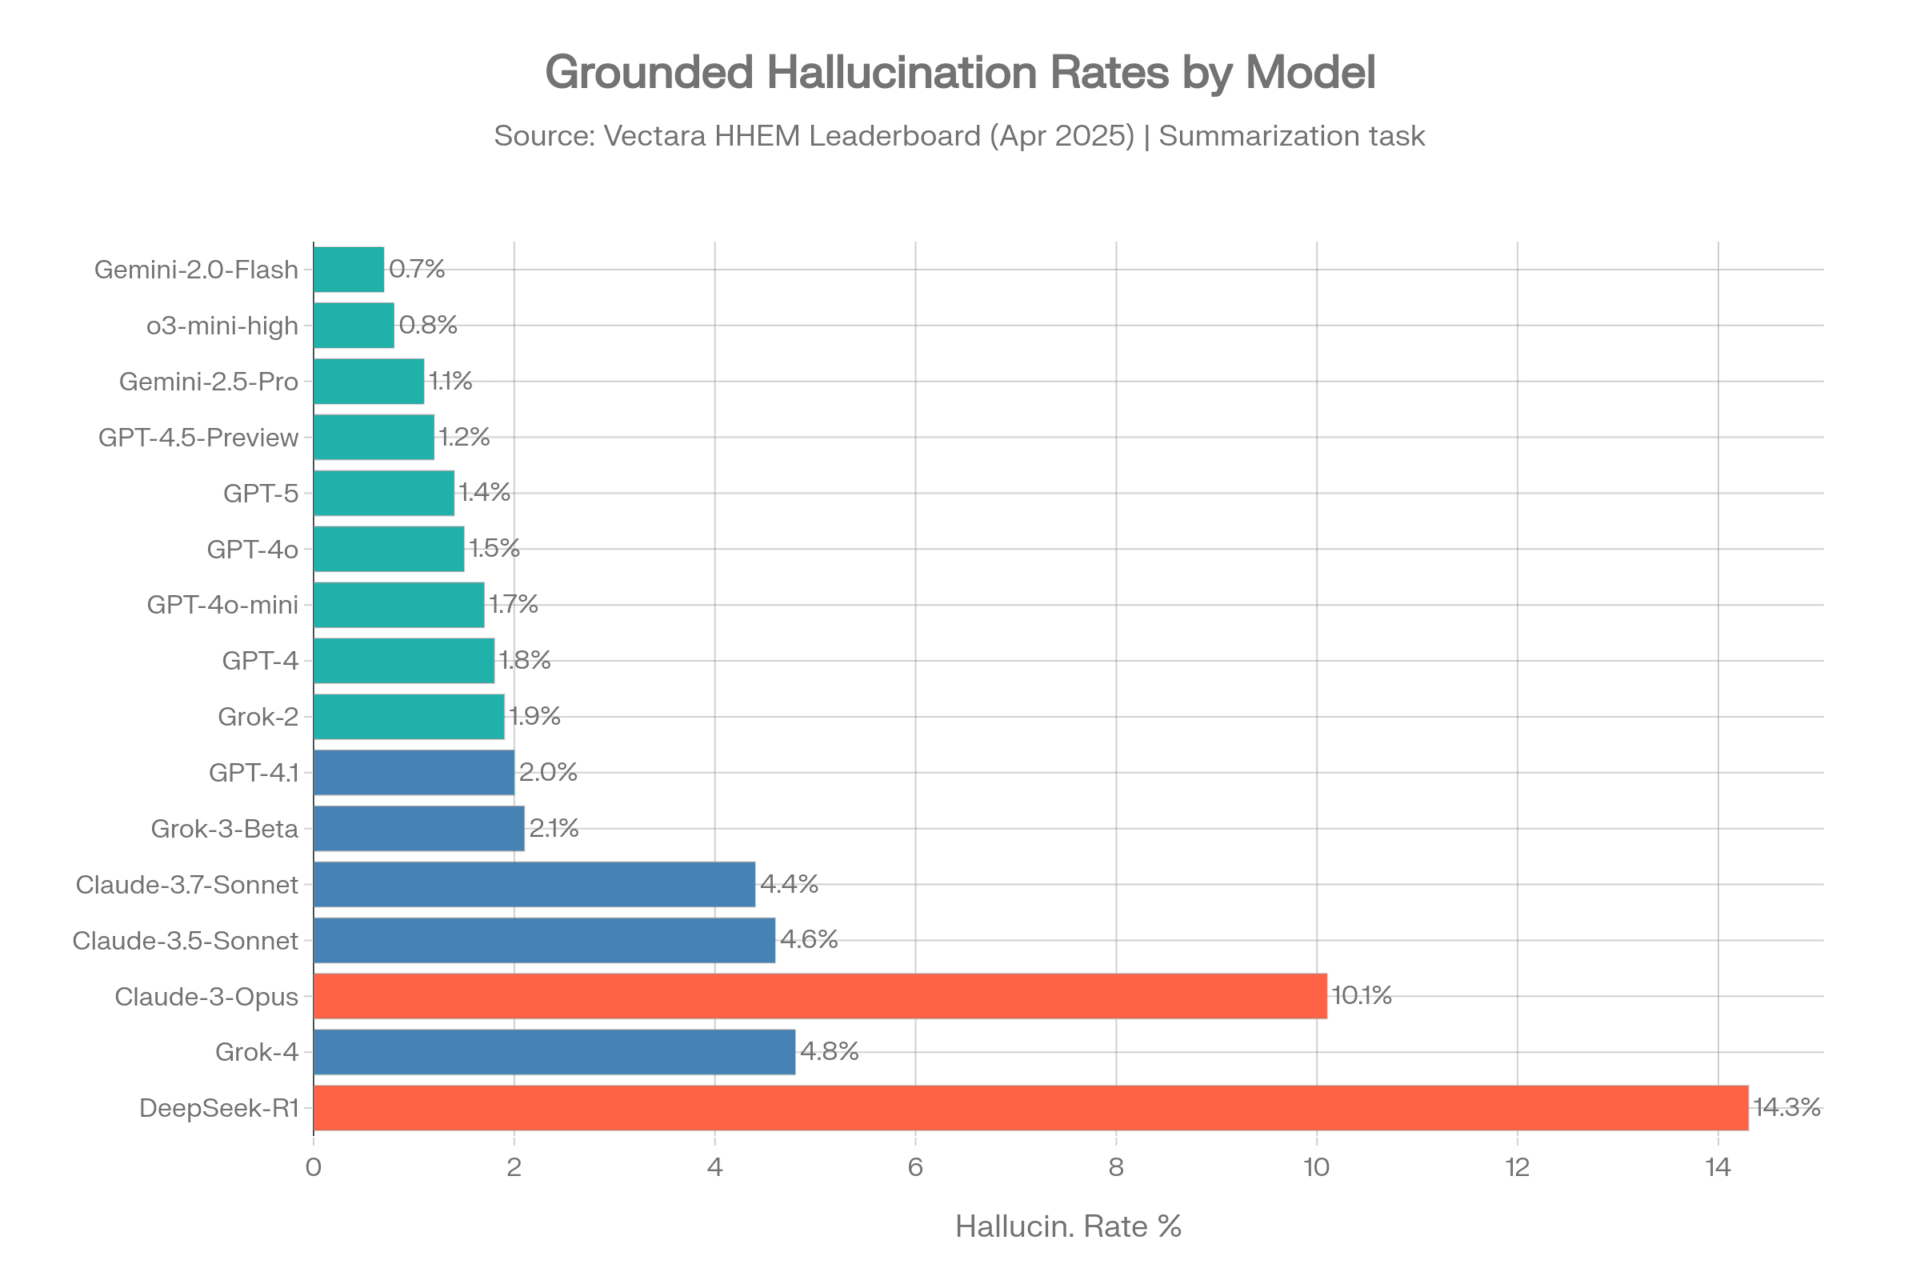
El conjunto de datos original de Vectara se convirtió en una referencia muy citada porque varios de los mejores modelos parecían alcanzar tasas de alucinación muy bajas en resúmenes controlados. Estas cifras siguen siendo útiles, pero deben presentarse como el rendimiento en un benchmark de resumen más sencillo y antiguo, no como una tasa de alucinación general para cualquier uso de la IA.
| Modelo | Proveedor | Tasa de alucinación | Consistencia fáctica |
| Gemini-2.0-Flash-001 | 0,7 % | 99,3 % | |
| Gemini-2.0-Pro-Exp | 0,8 % | 99,2 % | |
| o3-mini-high | OpenAI | 0,8 % | 99,2 % |
| Gemini-2.5-Pro-Exp | 1,1 % | 98,9 % | |
| GPT-4.5-Preview | OpenAI | 1,2 % | 98,8 % |
| Gemini-2.5-Flash-Preview | 1,3 % | 98,7 % | |
| GPT-5 / ChatGPT-5 | OpenAI | 1,4 % | 98,6 % |
| GPT-4o | OpenAI | 1,5 % | 98,5 % |
| GPT-4.1 | OpenAI | 2,0 % | 98,0 % |
| Grok-3-Beta | xAI | 2,1 % | 97,8 % |
| Claude-3.7-Sonnet | Anthropic | 4,4 % | 95,6 % |
| Grok-4 | xAI | 4,8 % | ~95.2% |
| Claude-3-Opus | Anthropic | 10,1 % | 89,9 % |
| DeepSeek-R1 | DeepSeek | 14,3 % | 85,7 % |
Interpretación: son resultados de resumen controlado. No significan que un modelo vaya a alucinar solo el 0,7 % de las veces en investigación jurídica, análisis financiero, asesoramiento médico o investigación web abierta.
Tasas de alucinación: nuevo conjunto de datos (noviembre de 2025)
Vectara renovó el benchmark a finales de 2025 con un conjunto de datos mucho más exigente: más de 7.700 artículos, documentos de hasta 32.000 tokens y contenido que abarca tecnología, bolsa, deportes, ciencia, política, medicina, derecho, finanzas, educación y negocios. El benchmark actualizado calcula la tasa de alucinación solo sobre los artículos que un modelo llega a resumir, mientras que las negativas a responder reducen la tasa de respuesta.
Los resultados son más altos por diseño. El nuevo benchmark refleja mejor los documentos empresariales complejos y diferencia a los modelos con más claridad.
| Modelo | Proveedor | Tasa de alucinación |
| Gemini-2.5-Flash-Lite | 3,3 % | |
| Mistral-Large | Mistral | 4,5 % |
| DeepSeek-V3.2-Exp | DeepSeek | 5,3 % |
| GPT-4.1 | OpenAI | 5,6 % |
| Grok-3 | xAI | 5,8 % |
| DeepSeek-R1-0528 | DeepSeek | 7,7 % |
| Claude Sonnet 4.5 | Anthropic | >10% |
| GPT-5 | OpenAI | >10% |
| Grok-4 | xAI | >10% |
| Gemini-3-Pro | 13,6 % |
Conclusión clave de Vectara
Los datos antiguos de Vectara mostraban que los mejores modelos podían mantenerse muy fieles en tareas de resumen más cortas y sencillas. Los datos nuevos muestran que, cuando los artículos se vuelven más largos, más complejos y más parecidos a los documentos empresariales, las tasas de alucinación suben. Para las empresas, la lección es sencilla: las cifras de un benchmark solo son útiles cuando el benchmark se parece a tu flujo de trabajo real.
Benchmark 2: AA-Omniscience (Artificial Analysis)
Qué mide
AA-Omniscience es un benchmark de conocimiento y alucinaciones de Artificial Analysis. Abarca 6.000 preguntas sobre 42 temas en seis dominios: Negocios, Humanidades y Ciencias Sociales, Salud, Derecho, Ingeniería de Software, y Ciencia, Ingeniería y Matemáticas.
La diferencia clave es que AA-Omniscience penaliza las conjeturas. Una respuesta correcta suma puntos, una incorrecta los resta y abstenerse se puntúa de forma distinta a inventarse algo con total seguridad. Eso lo convierte en un benchmark de gestión de la incertidumbre, no solo de conocimiento bruto.
Resultados
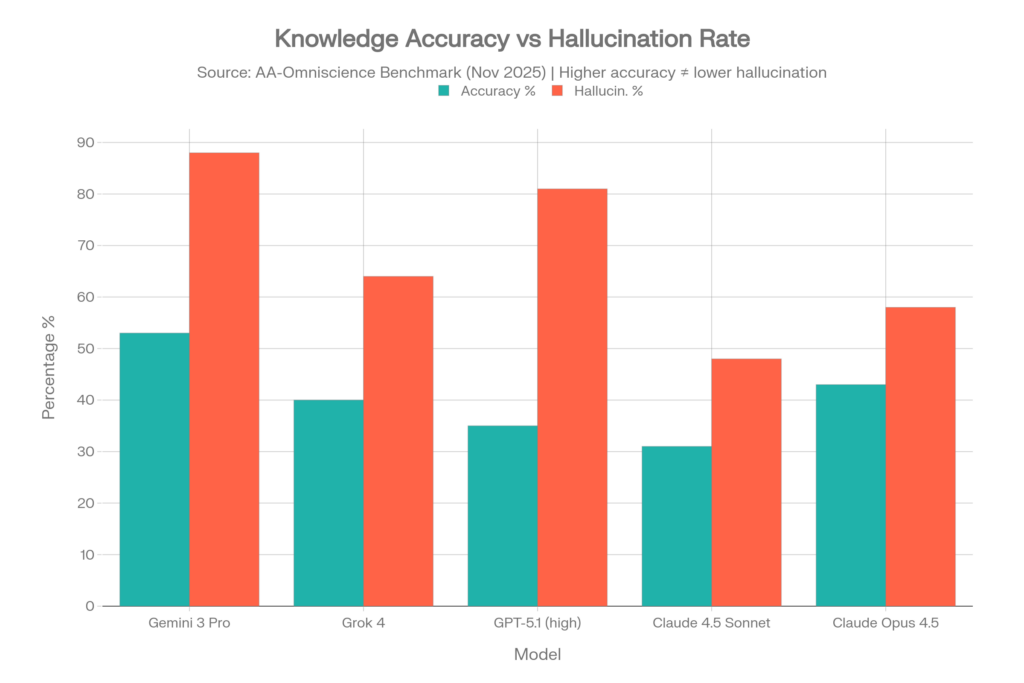
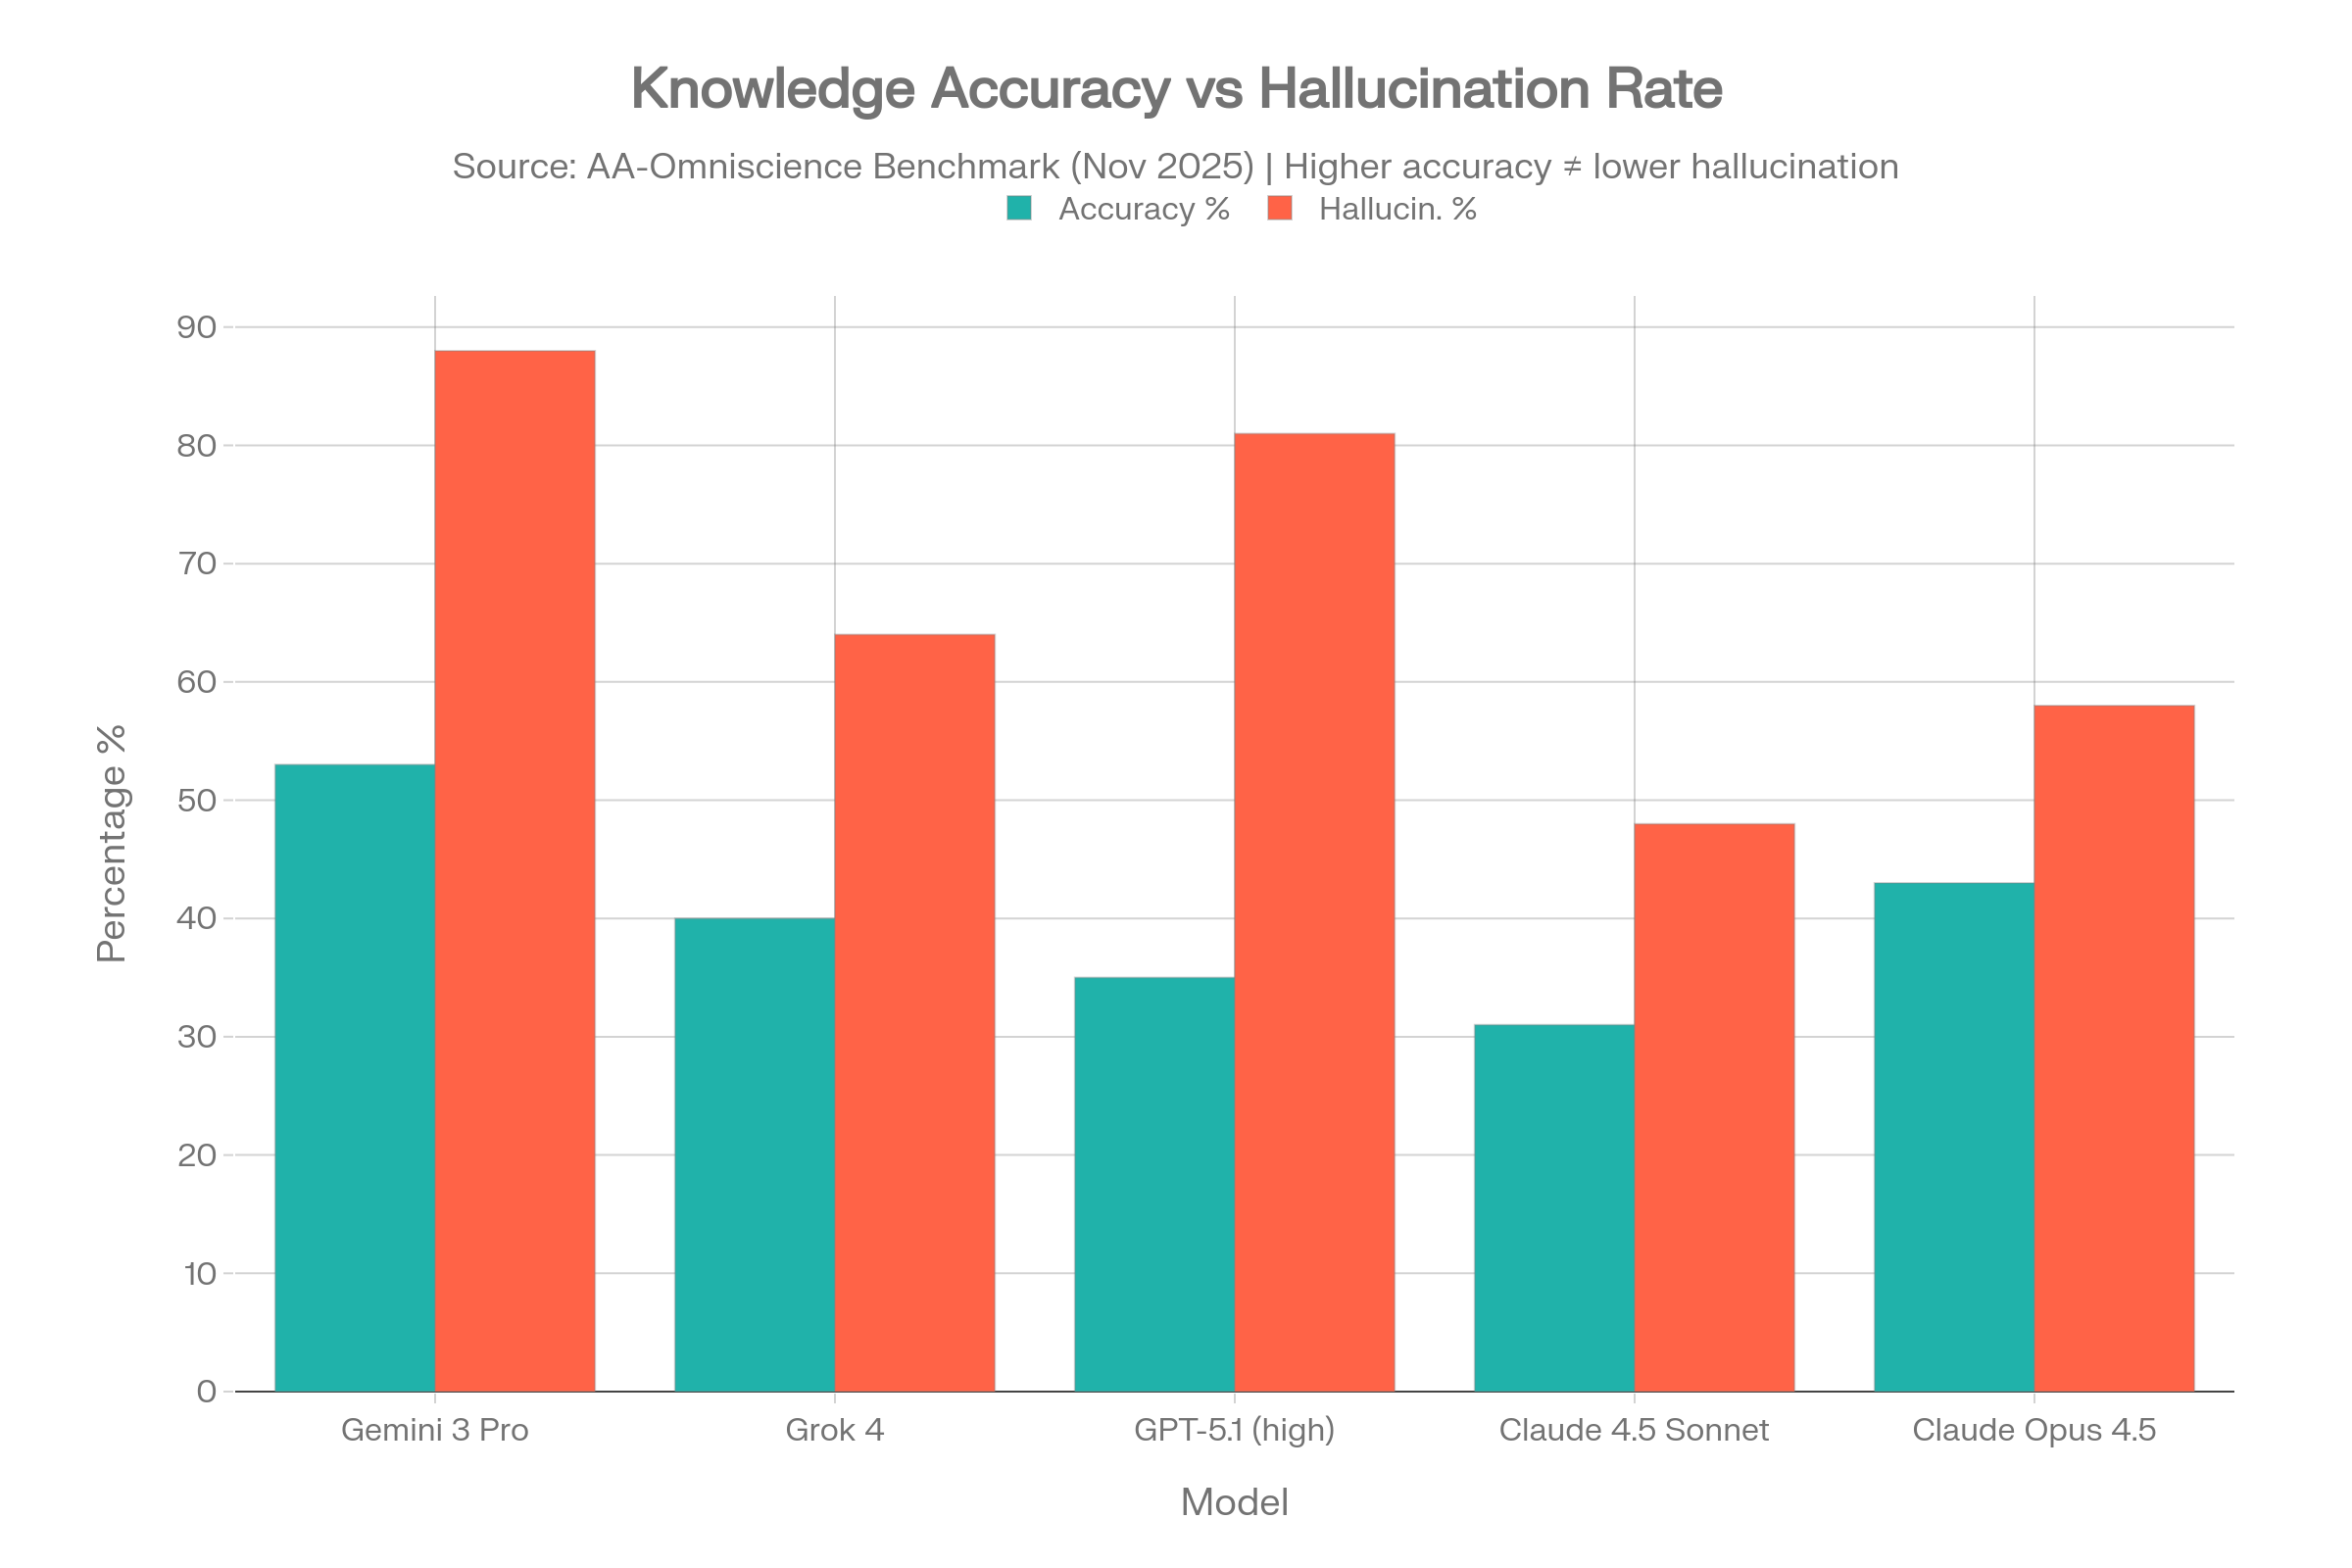
AA-Omniscience muestra por qué «precisión» y «fiabilidad» no son lo mismo. Un modelo puede responder correctamente muchas preguntas y aun así ser peligroso cuando no sabe la respuesta, porque puede adivinar en lugar de abstenerse.
| Modelo | Precisión / fortaleza reportada | Señal de alucinación / fiabilidad reportada | Interpretación |
| Claude 4.1 Opus | Sólido en general | Mejor resultado en el Omniscience Index según los datos del artículo original | Buena gestión de la incertidumbre en este benchmark |
| Claude 4.5 Haiku | No es el modelo con mayor precisión | La tasa de alucinación más baja reportada, en torno al 26-28 % | Se abstiene mejor cuando no está seguro |
| Gemini 3 Pro | Precisión bruta muy alta en la tabla del artículo | Señal alta de exceso de confianza / alucinación | Sabe mucho, pero puede estar demasiado dispuesto a adivinar |
| Grok 4 | Sólido en los dominios de Salud y Ciencia | Señal de alucinación aún considerable | La fortaleza en un dominio no elimina el exceso de confianza |
| Familia GPT-5 / GPT-5.1 | Precisión bruta sólida en algunos dominios | La fiabilidad depende mucho de la tarea y la configuración | No interpretes una sola puntuación como fiabilidad universal |
Advertencia importante: la tasa de alucinación de AA-Omniscience no equivale al «porcentaje de todas las respuestas cotidianas que son falsas». Es una métrica de exceso de confianza ante preguntas difíciles. Su utilidad está en que comprueba si los modelos saben cuándo no deben responder.
Líderes por dominio específico
Ningún modelo domina todos los dominios de conocimiento. Artificial Analysis identificó líderes distintos en derecho, ingeniería de software, humanidades, negocios, salud y ciencia. Esto refuerza los argumentos prácticos a favor de la selección de modelos, la comparación multimodelo y los flujos de verificación, en lugar de confiar en un único «mejor» modelo para todo.
Benchmark 3: estudio de citas de Columbia Journalism Review
En marzo de 2025, Columbia Journalism Review evaluó ocho herramientas de búsqueda generativa con funciones de búsqueda en tiempo real. Los investigadores seleccionaron 200 artículos de noticias de 20 medios, facilitaron a cada herramienta fragmentos literales y le pidieron que identificara el titular original, el medio, la fecha de publicación y la URL. En un total de 1.600 consultas, las herramientas dieron respuestas incorrectas más del 60 % de las veces.
| Herramienta | Tasa de error de citación / recuperación |
| Perplexity | 37 % |
| Microsoft Copilot | 40 % |
| Perplexity Pro | 45 % |
| ChatGPT Search | 67 % |
| DeepSeek Search | 68 % |
| Google Gemini | 76 % |
| Grok-2 | 77 % |
| Grok-3 | 94 % |
Interpretación: no se trata de una «tasa de alucinación del modelo» en sentido amplio, sino de una prueba de fiabilidad de citación y recuperación. Importa porque muchos usuarios dan por hecho que las herramientas de búsqueda con IA son más seguras simplemente porque ofrecen enlaces. Los resultados de CJR demuestran que los enlaces no garantizan que la respuesta esté fundamentada, completa o correctamente atribuida.
Benchmark 4: resultados de OpenAI sobre factualidad y modelos de razonamiento
La ficha técnica (system card) de o3 y o4-mini de OpenAI es útil porque revela un patrón contraintuitivo: los modelos de razonamiento más recientes pueden rendir mejor en algunas tareas y, aun así, alucinar más en benchmarks de preguntas y respuestas factuales.
| Conjunto de datos | Métrica | o3 | o4-mini | o1 |
| SimpleQA | Precisión | 49 % | 20 % | 47 % |
| SimpleQA | Tasa de alucinación | 51 % | 79 % | 44 % |
| PersonQA | Precisión | 59 % | 36 % | 47 % |
| PersonQA | Tasa de alucinación | 33 % | 48 % | 16 % |
La explicación de OpenAI es que o3 tiende a hacer más afirmaciones en general, lo que puede dar lugar tanto a más afirmaciones correctas como a más afirmaciones incorrectas. Es una advertencia útil para los usuarios empresariales: una respuesta más larga, más segura y más «razonada» no es automáticamente más fiable.
Benchmark 5: HalluHard y la fundamentación difícil en varios turnos
HalluHard, publicado en 2026, es importante porque evalúa un modo de fallo más realista: conversaciones de varios turnos que exigen citas dentro del texto para las afirmaciones factuales. El benchmark incluye 950 preguntas semilla sobre casos judiciales, preguntas de investigación, guías médicas y programación.
La conclusión principal es que la búsqueda web ayuda, pero no resuelve las alucinaciones. Incluso la configuración con mejores resultados, Opus-4.5 con búsqueda web, seguía alucinando aproximadamente un 30 % de las veces en este exigente escenario de varios turnos. Es uno de los mejores argumentos en contra de tratar la recuperación, la búsqueda o las citas como una solución completa.
Tasas de alucinación específicas por dominio
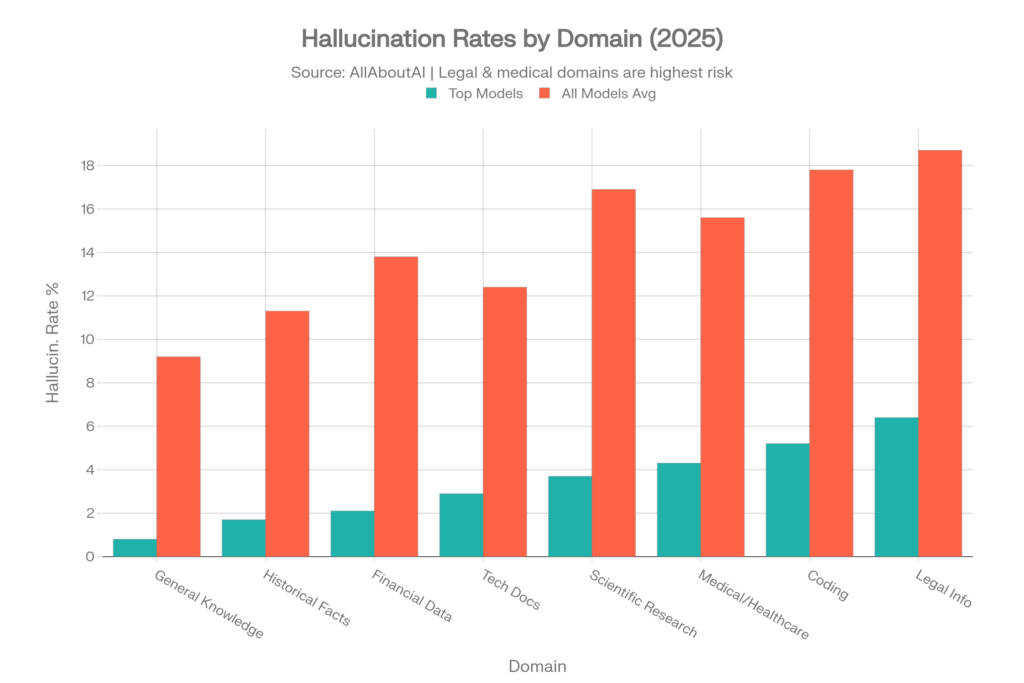
El riesgo de alucinación cambia según el dominio. El resumen general y el recuerdo de hechos no son lo mismo que la investigación jurídica, la orientación médica, el análisis financiero, la programación o la investigación basada en citas. El planteamiento editorial más prudente es este: las tasas por dominio varían mucho y cualquier benchmark debe interpretarse en el contexto de la tarea que evalúa.
| Dominio o flujo de trabajo | Señal de fiabilidad reciente | Por qué importa |
| Investigación jurídica | Las herramientas de IA jurídica diseñadas para ello seguían alucinando entre más del 17 % y más del 34 % de las veces en las pruebas de Stanford HAI | Las alucinaciones legales pueden generar precedentes falsos, argumentos mal fundamentados y riesgo de sanciones |
| Chatbots sanitarios | ECRI situó el mal uso de los chatbots de IA en la sanidad como el principal peligro de tecnología sanitaria para 2026 | La desinformación médica expresada con seguridad puede afectar a las decisiones de los pacientes y a los flujos de trabajo clínicos |
| Detección de alucinaciones médicas | MedHallu comprobó que el mejor modelo solo alcanzaba un F1 de 0,625 en la detección de alucinaciones médicas difíciles | A los modelos les cuesta detectar las alucinaciones médicas sutiles, no solo evitarlas |
| Citas de noticias | CJR detectó más de un 60 % de respuestas incorrectas en total entre las herramientas de búsqueda generativa | Los enlaces a fuentes no garantizan una atribución correcta |
| Investigación en varios turnos | HalluHard detectó aproximadamente un 30 % de alucinaciones incluso con búsqueda web en la configuración con mejores resultados | Los errores se acumulan en los flujos de trabajo más largos |
Análisis en profundidad de alucinaciones médicas
El riesgo de alucinación médica debe plantearse ahora en dos niveles: si la IA da información médica falsa y si la IA es capaz de detectar falsedades sutiles en respuestas médicas. MedHallu, un benchmark de 2025 construido a partir de 10.000 pares de pregunta-respuesta derivados de PubMedQA, comprobó que modelos de última generación como GPT-4o, Llama-3.1 y UltraMedical tenían dificultades para detectar alucinaciones médicas difíciles. El mejor modelo solo alcanzó un F1 de 0,625 en la categoría de alucinaciones difíciles.
La lista de peligros de tecnología sanitaria de ECRI para 2026 también ha llevado la cuestión de la preocupación general por la IA a un riesgo concreto de seguridad sanitaria. ECRI situó el mal uso de los chatbots de IA en la sanidad como el peligro número uno y señaló que los chatbots generalistas como ChatGPT, Claude, Copilot, Gemini y Grok no están regulados como dispositivos médicos ni validados para fines sanitarios.
Análisis en profundidad de alucinaciones legales
El estudio sobre IA jurídica de Stanford RegLab y Stanford HAI sigue siendo una de las pruebas más importantes del riesgo de alucinación legal. El estudio constató que Lexis+ AI y Ask Practical Law AI alucinaban cada uno más del 17 % de las veces, mientras que Westlaw AI-Assisted Research alucinaba más del 34 % de las veces en consultas exigentes de investigación jurídica.
Esto es especialmente importante porque las alucinaciones legales no suelen ser simples «datos erróneos». Pueden ser citas mal fundamentadas, casos inventados, precedentes inaplicables, citas textuales falsas o criterios jurídicos incorrectos. Una cita puede parecer real y, sin embargo, no respaldar el argumento que se defiende.
Impacto empresarial en el mundo real: las cifras
Un panorama del riesgo empresarial con mejores fuentes
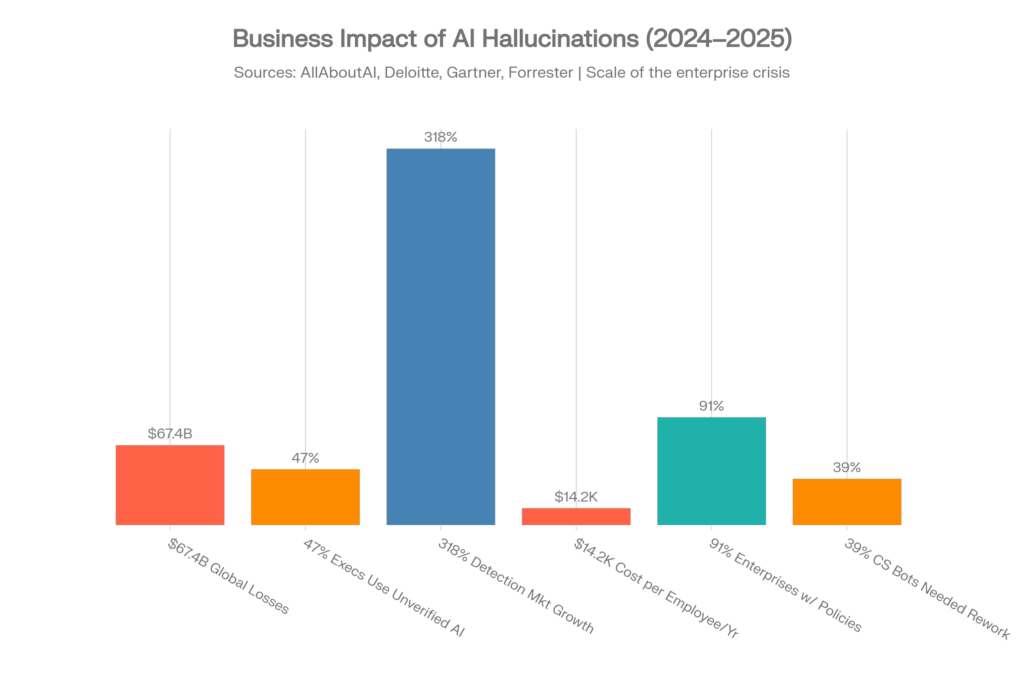
El panorama del riesgo empresarial mejor documentado procede ahora de encuestas sobre adopción y riesgo de la IA en las empresas, y no de estimaciones de pérdidas globales sin fuente. La encuesta global sobre IA de 2025 de McKinsey ofrece una visión más clara de lo extendido que está ya el uso de la IA y de la frecuencia con la que las organizaciones sufren consecuencias negativas por la inexactitud de la IA.
| Métrica | Valor actualizado | Por qué importa |
| Organizaciones que declaran un uso habitual de la IA | 88 % | El riesgo de la IA ya es generalizado, no experimental |
| Organizaciones que aún no escalan la IA a toda la empresa | Casi dos tercios | Muchas empresas usan IA antes de contar con una gobernanza madura |
| Organizaciones que usan IA y han sufrido al menos una consecuencia negativa | 51 % | Los fallos de la IA ya son visibles en entornos de producción |
| Encuestados que declaran consecuencias negativas por la inexactitud de la IA | Casi un tercio | La inexactitud es una de las categorías de riesgo empresarial más claras |
| Organizaciones que al menos experimentan con agentes de IA | 62 % | Las alucinaciones pasan de ser un riesgo de contenido a un riesgo en los flujos de trabajo y las decisiones |
| Organizaciones que escalan la IA agéntica en al menos una función | 23 % | Los sistemas agénticos hacen más urgentes la verificación y la supervisión |
La paradoja de la productividad
El problema de productividad no es solo que la IA pueda equivocarse. Es que puede equivocarse de formas que parecen acabadas, fluidas y verosímiles. Cuanto más entra la IA en informes, atención al cliente, redacción jurídica, investigación, analítica y toma de decisiones interna, más necesitan las organizaciones flujos de verificación integrados en el proceso, y no añadidos al final.
La pregunta práctica para las empresas ya no es «¿qué IA no alucina nunca?». Cualquier sistema actual puede fallar. La pregunta útil es: ¿qué capa de verificación detecta las afirmaciones sin respaldo antes de que lleguen a un cliente, un consumidor, un tribunal, un paciente, un inversor o un responsable de decisiones interno?
Incidentes legales: la crisis en los tribunales
Las cifras empeoran, no mejoran
Las alucinaciones legales son uno de los ejemplos reales más claros de falsedades generadas por IA con consecuencias profesionales. La base de datos AI Hallucination Cases de Damien Charlotin ya registra 1.450 casos identificados. La base de datos recopila resoluciones y documentos judiciales en los que un tribunal aborda, más allá de una mención de pasada, el uso de IA, ya sea probado o presunto.
El recuento actual de casos demuestra que la jurisprudencia alucinada, las citas textuales falsas, los precedentes tergiversados y los argumentos jurídicos generados por IA ya no son incidentes aislados.
¿Quién comete estos errores?
El problema no se limita a los litigantes que se representan a sí mismos. La base de datos incluye abogados, litigantes sin representación letrada, jueces, peritos y otros participantes en procedimientos judiciales. Esto importa porque los profesionales del derecho suelen usar la IA en flujos de trabajo en los que una sola cita inventada puede echar por tierra un escrito, provocar sanciones o dañar la confianza del cliente.
Qué hace que las alucinaciones legales sean especialmente peligrosas
- Los casos falsos parecen reales: los nombres de casos y las citas inventados suelen seguir formatos jurídicos conocidos.
- Los casos reales pueden usarse mal: un modelo puede citar un caso real que no respalda el argumento jurídico.
- La jurisdicción importa: un caso semánticamente similar puede ser jurídicamente irrelevante porque procede del tribunal, el periodo o el contexto jurídico equivocados.
- La verificación es cara: si hay que comprobar manualmente cada argumento y cada cita, la ganancia de productividad de la IA puede desaparecer.
Sanidad: donde las alucinaciones pueden matar
Los chatbots de IA son ya uno de los mayores peligros sanitarios
La lista de peligros de tecnología sanitaria de ECRI para 2026 sitúa el mal uso de los chatbots de IA en la sanidad como el peligro número uno. Es un planteamiento más preciso y actual que decir simplemente que el «riesgo de la IA» preocupa al sector sanitario. El riesgo es que los chatbots de uso general pueden dar respuestas médicas que suenan expertas, aunque no están regulados como dispositivos médicos ni han sido validados para fines sanitarios.
FDA y preocupaciones sobre dispositivos médicos
La FDA mantiene una lista pública de dispositivos médicos con IA autorizados para su comercialización en Estados Unidos. La página indica que la lista se actualiza periódicamente y que su objetivo es aportar transparencia a los profesionales sanitarios, los pacientes y los innovadores en salud digital. Sin embargo, la página de la FDA consultada para esta actualización no indicaba explícitamente un recuento total en su texto, por lo que cualquier cifra concreta de dispositivos debe verificarse directamente antes de publicarse.
Desinformación médica con IA
Las alucinaciones médicas son peligrosas porque pueden sonar a consejo profesional. Un chatbot puede sugerir un diagnóstico incorrecto, recomendar pruebas innecesarias, tergiversar guías clínicas o dar instrucciones peligrosas con un tono sereno y autorizado. ECRI advierte expresamente de que las organizaciones sanitarias deben aplicar una supervisión rigurosa, directrices detalladas, formación de los clínicos, auditorías de rendimiento y verificación con fuentes expertas.
Tendencia histórica: el progreso es real, pero desigual
Las buenas noticias
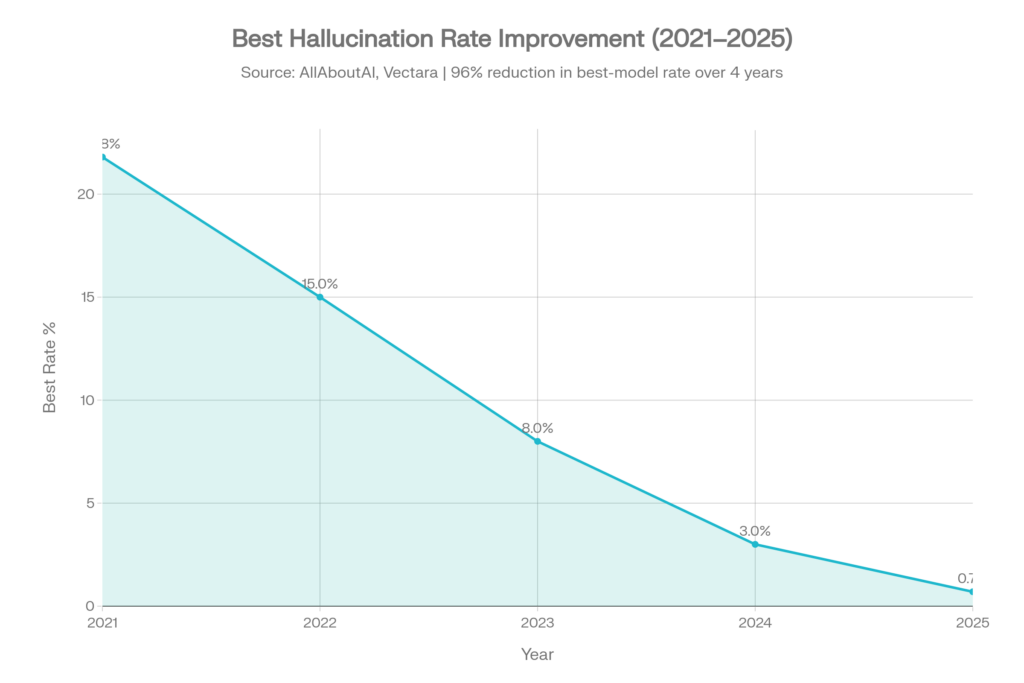
Los modelos han mejorado notablemente en muchas tareas controladas de factualidad y resumen. Los modelos antiguos alucinaban con más frecuencia en benchmarks sencillos, y los más recientes pueden ser muchísimo mejores cuando la tarea es acotada, se proporciona el material de origen y la evaluación es clara.
Las malas noticias
- La mejora depende del benchmark. Un modelo que rinde bien en resúmenes puede fallar en citas, investigación jurídica o razonamiento médico.
- Los benchmarks más exigentes revelan brechas mayores. El nuevo benchmark de Vectara registra tasas más altas que el antiguo porque los documentos son más largos y complejos.
- El razonamiento es un arma de doble filo. Los modelos de razonamiento pueden resolver tareas más difíciles, pero también pueden hacer más afirmaciones, lo que multiplica las ocasiones de introducir afirmaciones sin respaldo.
- La búsqueda web no es una solución completa. HalluHard siguió detectando alucinaciones considerables en la configuración con mejores resultados, incluso con búsqueda web.
Resumen modelo por modelo para los modelos de Suprmind.ai
Las comparaciones entre modelos deben tratarse como específicas de cada benchmark. La forma más segura de presentar la fiabilidad de un modelo es indicar de qué benchmark procede la cifra y qué tarea mide.
| Familia de modelos | Qué sugieren los datos actuales | Mejor uso de los datos |
| Modelos de OpenAI | Sólidos en muchas tareas, pero los datos de la ficha técnica de o3 y o4-mini muestran tasas de alucinación altas en SimpleQA y PersonQA en algunas configuraciones | Usa benchmarks de factualidad y comprobación de fuentes en flujos de trabajo con mucha carga factual |
| Modelos Claude de Anthropic | Señales sólidas de gestión de la incertidumbre en AA-Omniscience para algunas variantes de Claude | Útiles cuando importan la abstención y la prudencia, pero siguen requiriendo verificación |
| Modelos Google Gemini | Resultados sólidos en Vectara para algunas variantes de Gemini, pero con señales altas de exceso de confianza en un enfoque tipo AA-Omniscience | No confundas la fidelidad en resúmenes con una fiabilidad factual universal |
| Modelos Grok de xAI | Resultados dispares según el benchmark, incluidas altas tasas de error de citación de Grok-3 en el estudio de CJR | Evalúa por tarea, no por afirmaciones genéricas sobre la marca |
| Perplexity / Sonar | CJR comprobó que Perplexity fue la que mejor rindió entre las herramientas de búsqueda con IA evaluadas, pero aun así tuvo una tasa de error de citación/recuperación del 37 % | Un claro recordatorio de que incluso los enlaces reales requieren verificar el contenido de la fuente |
Qué reduce realmente las alucinaciones
Ninguna técnica de mitigación elimina las alucinaciones. El mejor enfoque es la verificación por capas: recuperación de información, citas, comportamiento de abstención, comparación multimodelo, prompts estructurados, comprobación a nivel de fuente y revisión humana para los resultados de alto riesgo.
| Capa de mitigación | En qué ayuda | Limitación |
| Generación aumentada por recuperación (RAG) | Fundamenta las respuestas en documentos o bases de datos proporcionados | El modelo puede seguir malinterpretando o fundamentando mal el material recuperado |
| Búsqueda web | Mejora el acceso a información actualizada | El modelo puede recuperar fuentes poco fiables o citar fuentes que no respaldan la afirmación |
| Exigencia de citar fuentes | Facilita la auditoría de las afirmaciones | Una cita puede ser inventada, estar rota, ser irrelevante o usarse mal |
| Abstención / comportamiento de «no estoy seguro» | Reduce las conjeturas cuando el modelo carece de evidencia | Puede reducir la tasa de respuesta o frustrar a los usuarios si no está bien diseñada |
| Verificación multimodelo | Saca a la luz los desacuerdos y detecta algunos errores de un solo modelo | Varios modelos pueden compartir el mismo punto ciego |
| Revisión humana | Imprescindible en trabajos jurídicos, médicos, financieros, regulatorios y de cara al cliente | Requiere tiempo, procesos y conocimiento del dominio |
La alucinación más peligrosa: la que no detectas
La alucinación más peligrosa no es el error evidente. Es el verosímil: una cita que parece real, un resumen convincente, una estadística de mercado creíble, un caso judicial que suena familiar o una explicación médica redactada en tono profesional. Estos errores son peligrosos porque pueden atravesar los flujos de trabajo sin que nadie los note.
Por eso la prevención de alucinaciones no debe plantearse como una única herramienta ni como un truco puntual de prompt. Es un sistema de calidad. Las organizaciones que más se beneficien de la IA serán las que integren la verificación directamente en el flujo de trabajo, en lugar de tratarla como una limpieza a posteriori.
Glosario de definiciones clave
| Término | Definición |
| Alucinación | Contenido generado por IA que es falso, inventado, sin respaldo o mal fundamentado, pero que se presenta con total seguridad |
| Alucinación de fidelidad | Información falsa o sin respaldo introducida al resumir o responder a partir del material de origen proporcionado |
| Alucinación de factualidad | Hechos, estadísticas, fuentes, personas, acontecimientos o afirmaciones inventados sin base verificada |
| Alucinación de citas | Una cita inventada, rota, mal atribuida o sin respaldo |
| Fundamentación errónea | Se cita una fuente real, pero esta no respalda la afirmación que se hace |
| RAG (generación aumentada por recuperación) | Técnica que conecta los sistemas de IA con documentos, bases de datos o bases de conocimiento externos antes de generar una respuesta |
| HHEM | El Hughes Hallucination Evaluation Model de Vectara, que detecta afirmaciones sin respaldo en resúmenes |
| Omniscience Index | Métrica de Artificial Analysis que recompensa las respuestas correctas y penaliza las respuestas erróneas dadas con total seguridad |
| Abstención | El modelo se niega a responder o dice que no lo sabe en lugar de adivinar |
| Complacencia (sycophancy) | Tendencia de un modelo a dar la razón al usuario sobre su premisa incluso cuando esa premisa es errónea |
Resumen de fuentes
Principales benchmarks y estudios citados en esta versión actualizada:
- Clasificación de alucinaciones de Vectara: benchmark de resumen HHEM original y de nueva generación, incluido el conjunto de datos actualizado de más de 7.700 artículos. Fuente: Vectara.
- AA-Omniscience de Artificial Analysis: benchmark de conocimiento y alucinaciones que mide la precisión, la abstención y el exceso de confianza en 6.000 preguntas. Fuente: Artificial Analysis.
- Columbia Journalism Review: estudio de 2025 sobre la precisión de las citas en la búsqueda con IA, con 1.600 consultas y ocho herramientas de búsqueda generativa. Fuente: Columbia Journalism Review.
- Ficha técnica de o3 y o4-mini de OpenAI: resultados de alucinación y precisión en SimpleQA y PersonQA para o3, o4-mini y o1. Fuente: ficha técnica de OpenAI (PDF).
- Stanford RegLab / Stanford HAI: estudio sobre alucinaciones de la IA jurídica en Lexis+ AI, Westlaw AI-Assisted Research y Ask Practical Law AI, con comparativas frente a modelos de uso general. Fuente: Stanford HAI.
- Base de datos AI Hallucination Cases de Damien Charlotin: base de datos actualizada de forma continua con resoluciones y documentos judiciales relacionados con alucinaciones de IA. Fuente: base de datos AI Hallucination Cases.
- Encuesta global sobre IA de 2025 de McKinsey: datos sobre adopción y escalado de la IA en las empresas, consecuencias negativas y riesgo de inexactitud de la IA. Fuente: McKinsey.
- Peligros de tecnología sanitaria 2026 de ECRI: clasificación de riesgos sanitarios que sitúa el mal uso de los chatbots de IA en la sanidad como el principal peligro. Fuente: ECRI.
- MedHallu: benchmark de 2025 de detección de alucinaciones médicas con 10.000 pares de pregunta-respuesta derivados de PubMedQA. Fuente: MedHallu en arXiv.
- HalluHard: benchmark de 2026 de alucinaciones difíciles en varios turnos en los ámbitos jurídico, de investigación, médico y de programación. Fuente: HalluHard en arXiv.